Appearance
HashMap、Hashtable、LinkedHashMap和TreeMap特点说明
Java为数据结构中的映射定义了一个接口java.util.Map,此接口主要有四个常用的实现类,分别是HashMap、Hashtable、LinkedHashMap和TreeMap,类继承关系如下图所示:
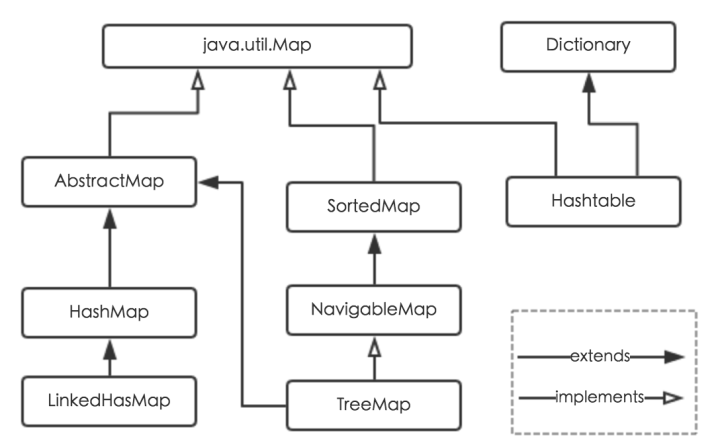
下面针对各个实现类的特点做一些说明:
HashMap
它根据键的hashCode值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap最多只允许一条记录的键为null,允许多条记录的值为null。HashMap非线程安全,即任一时刻可以有多个线程同时写HashMap,可能会导致数据的不一致。如果需要满足线程安全,可以用 Collections的synchronizedMap方法使HashMap具有线程安全的能力,或者使用ConcurrentHashMap。
Hashtable
Hashtable是遗留类,很多映射的常用功能与HashMap类似,不同的是它承自Dictionary类,并且是线程安全的,任一时间只有一个线程能写Hashtable,并发性不如ConcurrentHashMap,因为ConcurrentHashMap引入了分段锁。Hashtable不建议在新代码中使用,不需要线程安全的场合可以用HashMap替换,需要线程安全的场合可以用ConcurrentHashMap替换。
LinkedHashMap
LinkedHashMap是HashMap的一个子类,保存了记录的插入顺序,在用Iterator遍历LinkedHashMap时,先得到的记录肯定是先插入的,也可以在构造时带参数,按照访问次序排序。
TreeMap
TreeMap实现SortedMap接口,能够把它保存的记录根据键排序,默认是按键值的升序排序,也可以指定排序的比较器,当用Iterator遍历TreeMap时,得到的记录是排过序的。如果使用排序的映射,建议使用TreeMap。在使用TreeMap时,key必须实现Comparable接口或者在构造TreeMap传入自定义的Comparator,否则会在运行时抛出java.lang.ClassCastException类型的异常。
对于上述四种Map类型的类,要求映射中的key是不可变对象。不可变对象是该对象在创建后它的哈希值不会被改变。如果对象的哈希值发生变化,Map对象很可能就定位不到映射的位置了。
一、四个实现类六维对比表
| 维度 | HashMap | Hashtable | LinkedHashMap | TreeMap |
|---|---|---|---|---|
| 底层结构 | 数组+链表+红黑树(JDK8) | 数组+链表 | HashMap + 双向链表 | 红黑树 |
| 顺序 | 无序 | 无序 | 插入序 / 访问序(可配) | 按键排序(可配 Comparator) |
| null 键/值 | 1 个 null 键,多个 null 值 | 都不允许(抛 NPE) | 同 HashMap | null 值可以,null 键不行(比较时 NPE) |
| 线程安全 | 不安全 | 安全(全表一把锁) | 不安全 | 不安全 |
| 增删查复杂度 | O(1) 平均 | O(1) 平均,锁开销大 | O(1) 平均,维护链表略慢 | O(logN),天然有序的代价 |
| 典型场景 | 默认选型,通用 KV 缓存 | 遗留代码兼容 | LRU 缓存、顺序敏感 | 排序、范围查询(headMap/tailMap) |
补充两列易混点:Hashtable 的 t 是小写(历史遗留命名),它继承自古老的 Dictionary 而非 AbstractMap;ConcurrentHashMap 才是并发的正解(JDK7 分段锁 → JDK8 CAS + 桶级 synchronized,见 ConcurrentHashMap在JDK1.7的锁分段技术、HashMap与HashTable的区别);
LinkedHashMap 的"访问序"三件套:构造器
new LinkedHashMap<>(16, 0.75f, true)打开 accessOrder,重写removeEldestEntry()即可几行实现 LRU——手写 LRU 的面试标准答案;TreeMap 的 key 需要可比较:key 实现 Comparable 或构造时传 Comparator,两者都缺会在 put 第二个元素时抛 ClassCastException(红黑树插入要比较定位);
四者对 key 的共同要求即上文"key 不可变":key 的 hashCode 一旦变了,它就被"埋"在了错误的桶里,再也查不到——所以用可变对象当 key 是自找麻烦。
二、选型决策树
需要 Map,按什么选实现?
│
├─ 并发读写吗?
│    ├─ 是 → ConcurrentHashMap(不要再用 Hashtable)
│    └─ 否 ↓
│
├─ 需要 key 有序吗?
│    ├─ 要按键大小排序 / 范围查询 → TreeMap(key 可比较)
│    └─ 要插入序 / 访问序(LRU)→ LinkedHashMap
│              (注意:和"排序"不是一回事,LinkedHashMap 保序不排序)
│
└─ 都不需要 → HashMap(默认第一选择)
三、高频追问速答
"HashMap 为什么快?"——hashCode 直接定位桶,冲突链表在 JDK8 中超过 8 且数组够长会树化为红黑树,把最坏 O(N) 压到 O(logN),详见 HashMap底层数据结构、HashMap源码注释;
"为什么容量是 2 的幂?"——hash & (n-1) 代替取模,散列更均匀,详见 HashMap 的长度为什么是2的幂次方;
"LinkedHashMap 怎么做到有序?"——在 HashMap 节点上加了 before/after 两个指针串成双向链表,迭代走链表不走桶数组,所以容量翻倍重哈希后顺序依旧不丢;
"TreeMap 插入比 HashMap 慢多少?"——O(logN) vs O(1),数量级上差一个 log 因子;换来的是有序遍历和 headMap/tailMap/subMap 这类范围操作。
"并发且要 key 有序用什么?"——ConcurrentSkipListMap:跳表实现、CAS 无锁并发、存取 O(logN) 几乎与线程数无关,源码详见 ConcurrentSkipListMap源码;
HashMap 相关高频面试问题速查清单,见 HashMap面试问题罗列。
四、扩容与初始容量
HashMap 默认容量 16、负载因子 0.75,元素超过
容量 × 0.75触发扩容为 2 倍并 rehash;能预估数据量时给初始容量预计量 / 0.75 + 1可以避免多次扩容(阿里规约同款建议);LinkedHashMap 扩容复用 HashMap 的逻辑,仅需把双向链表整体搬到新表(JDK8 优化后保持相对位置,不用重排序);
TreeMap 没有扩容概念——红黑树按需生长,插入节点最多旋转两次重新着色恢复平衡;
Hashtable 默认容量 11、扩容 2n+1,这也是它"遗留感"的细节之一。
一句话总结:默认 HashMap;要顺序用 LinkedHashMap,要排序用 TreeMap,要并发用 ConcurrentHashMap,Hashtable 只在老代码里出现。
2026-10 扩充(Round1 查漏)。