Appearance
ConcurrentHashMap在JDK1.7的锁分段技术
看在前面
锁分段技术
HashTable 容器在竞争激烈的并发环境下效率低下。原因是所有访问 HashTable 的线程都必须竞争同一把锁。假如容器里有多把锁,每一把锁用于锁容器其中一部分数据。那么当多线程访问容器里不同数据段的数据时,线程间就不会存在锁竞争。从而可以有效的提高并发访问效率,这就是 ConcurrentHashMap 所使用的锁分段技术。
首先将数据分成一段一段的存储,然后给每一段数据配一把锁。当一个线程占用锁访问其中一个段数据的时候,其他段的数据也能被其他线程访问。
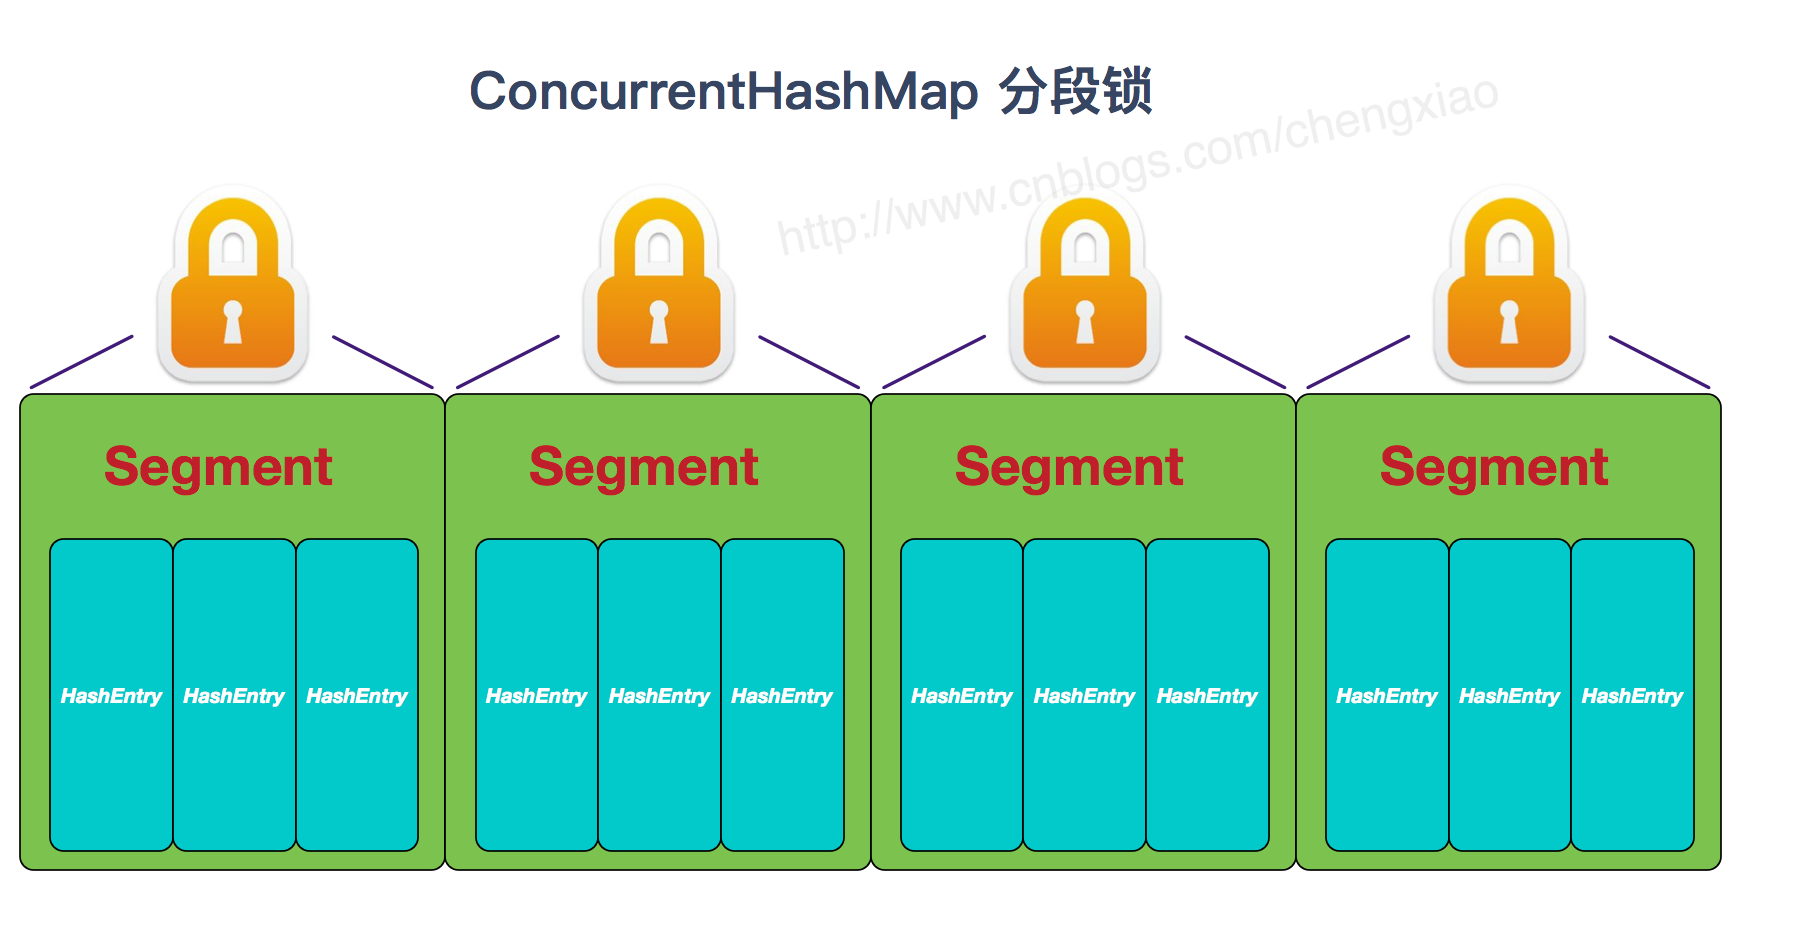
有些方法需要跨段,比如 size() 和 containsValue()。它们可能需要锁定整个表而不仅仅是某个段。这需要按顺序锁定所有段,操作完毕后又按顺序释放所有段的锁。这里"按顺序"很重要,否则极有可能出现死锁。在 ConcurrentHashMap 内部,Segment 数组是 final 的,这可以确保获得锁的顺序是固定的,从而不会出现死锁。
为什么弃用 HashMap / HashTable
- HashMap 线程不安全:多线程 put 可能引起死循环(扩容成环),导致 CPU 利用率接近 100%;
- HashTable 低效:所有方法都由 synchronized 修饰,一个线程 put 时其他线程连 get 都会被阻塞,竞争越激烈效率越低;
- 适用场景:读者数量超过写者时 ConcurrentHashMap 表现好;写多读少时性能反而不如 HashTable/synchronized Map。典型用法是做缓存:程序启动时初始化,之后被多个请求线程访问。
数据结构
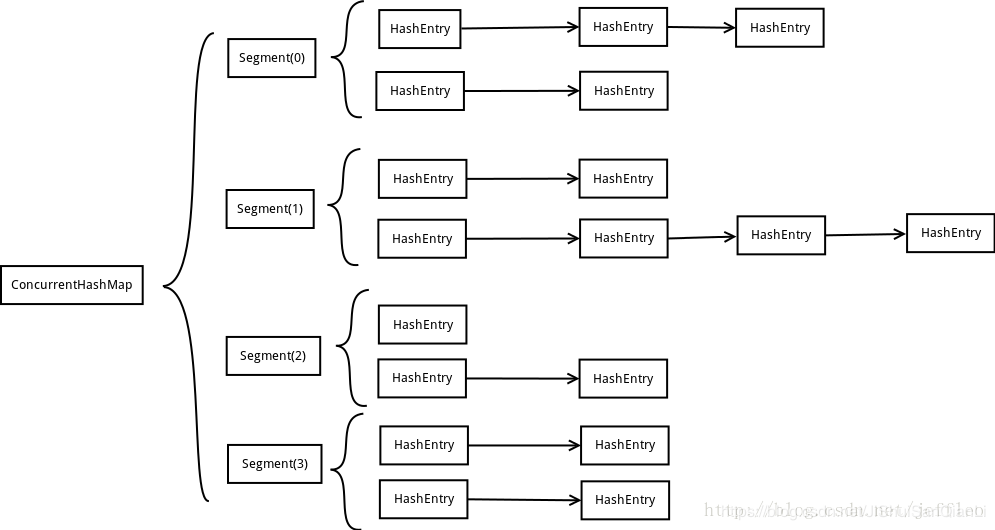
ConcurrentHashMap 由 Segment 数组结构和 HashEntry 数组结构组成:
- Segment 是一种可重入锁 ReentrantLock,在 ConcurrentHashMap 里扮演锁的角色;
- HashEntry 则用于存储键值对数据。一个 ConcurrentHashMap 里包含一个 Segment 数组,Segment 的结构和 HashMap 类似,是一种数组和链表结构,一个 Segment 里包含一个 HashEntry 数组;
- 每个 HashEntry 是一个链表结构的元素,每个 Segment 守护着一个 HashEntry 数组里的元素。当修改 HashEntry 数组的数据时,必须首先获得它对应的 Segment 锁。
Segment 的源码定义——继承 ReentrantLock,本身就是一把可重入锁:
java
static class Segment<K,V> extends ReentrantLock implements Serializable {
}即三层结构:ConcurrentHashMap(整个 Hash 表)→ Segment(桶 + 可重入锁)→ HashEntry(链表节点)。
关键成员变量
java
static final int DEFAULT_INITIAL_CAPACITY = 16;
static final float DEFAULT_LOAD_FACTOR = 0.75f;
static final int DEFAULT_CONCURRENCY_LEVEL = 16; // 初始并发等级(段数量)
static final int MIN_SEGMENT_TABLE_CAPACITY = 2;
static final int MAX_SEGMENTS = 1 << 16;
static final int RETRIES_BEFORE_LOCK = 2;- Segment 内部:
transient volatile HashEntry<K,V>[] table(volatile 保证读到最新值)、count(元素数)、modCount(结构修改次数)、threshold、loadFactor; - HashEntry:
final int hash; final K key; volatile V value; volatile HashEntry<K,V> next——value 和 next 都是 volatile; - 每段槽的个数为 2^n,用位运算定位。默认并发级别 16 时,hash 的高 4 位决定分配到哪个段(segmentShift=28,segmentMask=15);
- 定位段之前会用 Wang/Jenkins hash 变种算法再哈希,目的是减少冲突、让元素均匀分布到各 Segment。
get:全程不加锁
- 两次 hash:先定位 Segment,再定位 HashEntry;
- 全程不加锁,靠 HashEntry 的 volatile value 保证内存可见性,非常高效。
put:只锁单个 Segment
java
// Segment.put 流程(JDK1.7)
1. tryLock 获取锁,失败则调用 scanAndLockForPut 自旋重试
2. 定位 HashEntry,遍历链表:key 相等则覆盖旧 value
3. 链表为空则新建节点插入,插入前判断 c > threshold 决定是否 rehash- 扩容时机比 HashMap 更恰当:插入前判断(HashMap 是插入后才扩容,可能出现无效扩容);
- 扩容只针对单个 Segment(容量翻倍、元素再散列),不对整个容器扩容。
remove
先定位段再委托给 Segment.remove,不同段的删除可以并发。流程:tryLock 失败则 scanAndLock 自旋。遍历链表时用 pred 记录前驱,找到目标后让前驱的 next 指向被删节点的下一个(或更新头结点)。更新 modCount、count,最后 unlock。
跨段操作:size() 与 containsValue()
- size() 不能简单地把各段 volatile count 相加——累加过程中可能已有段发生变化,结果不准。做法:先尝试 2 次不加锁统计各段大小。通过比较 modCount 总和是否变化,来判断统计期间容器是否被修改。若连续两次 sum 相同则结果可信,否则对所有段加锁后再统计。modCount 在 put、remove、clean 前都会 +1,用于检测变化;
- containsValue() 同理:先无锁遍历并比较 modCount,自旋次数超过
RETRIES_BEFORE_LOCK(2 次)则强制给所有 segment 加锁后再遍历。
JDK1.8 的变化
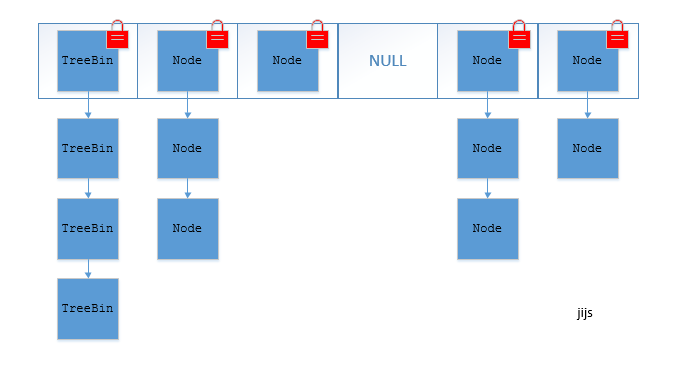
- 放弃 Segment 设计,改用 Node 数组 + CAS + synchronized(锁粒度细化到桶头节点)保证并发安全;
- 链表长度超过 TREEIFY_THRESHOLD(8)转红黑树(寻址从 O(N) 降到 O(log N)),树退化阈值 UNTREEIFY_THRESHOLD 为 6;
- 关键内部类:Node(val/next 为 volatile)、TreeNode、TreeBin(包装 TreeNode 完成红黑树的读写控制);
- put 流程:空槽 CAS 插入。hash==MOVED 时 helpTransfer 协助扩容。否则 synchronized 锁头节点做链表遍历或 putTreeVal 入树。binCount≥8 树化。最后 addCount 更新计数。
内容来源:原文 · 2026-10 整理回填。
2026-10 整改:并入原《Java集合/ConcurrentHashMap线程安全的具体实现方式、底层具体实现》。吸收其独有的 Segment 类定义源码与两张结构图,其余论述本篇已覆盖。