Appearance
Java对象模型
看在前面
- [Java内存区域]((原链已失效 2026-10,内容已在本篇/本库))。
- 《深入理解 Java 虚拟机:JVM 高级特性与最佳实践(第二版》。
- 《实战 java 虚拟机》。
- https://docs.oracle.com/javase/specs/index.html。
- (原链已失效 2026-10,内容已在本篇/本库)。
- https://dzone.com/articles/jvm-permgen-–-where-art-thou。
- https://stackoverflow.com/questions/9095748/method-area-and-permgen。
- 深入解析String#internhttps://tech.meituan.com/2014/03/06/in-depth-understanding-string-intern.html。
- 从虚拟机的角度看对象的创建与访问(第二来源:其分配并发安全细节、对象访问定位对比、对象内存布局详解已并入本文 3.1 / 3.2 / 3.3 节)
三 HotSpot 虚拟机对象探秘
通过上面的介绍,我们已了解虚拟机的内存情况。下文详细介绍 HotSpot 虚拟机在 Java 堆中对象分配、布局和访问的全过程。
3.1 对象的创建
下图便是 Java 对象的创建过程。建议默写这个过程,并掌握每一步在做什么。
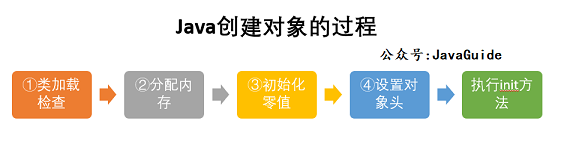
Step1:类加载检查
虚拟机遇到 new 指令时,首先检查指令的参数能否在常量池中定位到这个类的符号引用。再检查这个符号引用代表的类是否已被加载、解析和初始化。如果没有,那必须先执行相应的类加载过程。
Step2:分配内存
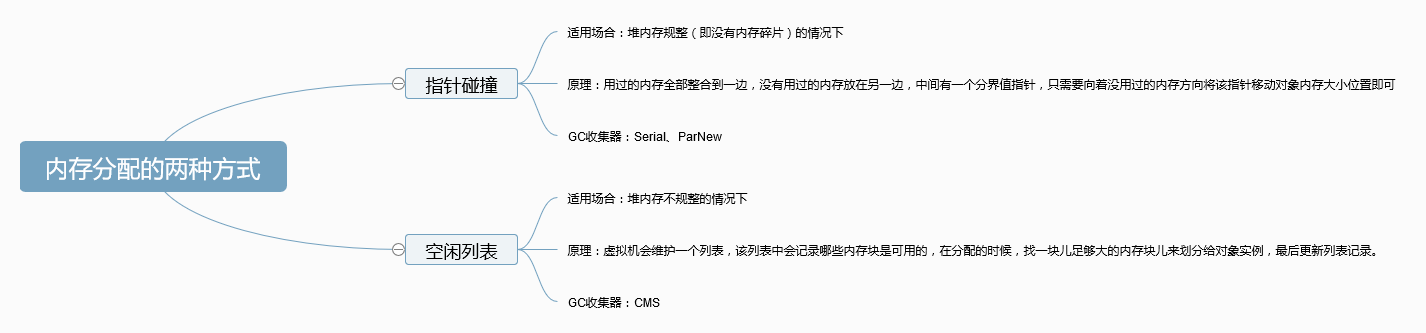
在类加载检查通过后,接下来虚拟机将为新生对象分配内存。对象所需的内存大小在类加载完成后便可确定。分配空间的任务等同于把一块确定大小的内存从 Java 堆中划分出来。分配方式有 “指针碰撞” 和 “空闲列表” 两种。选择哪种分配方式由 Java 堆是否规整决定。Java 堆是否规整又由所采用的垃圾收集器是否带有压缩整理功能决定。
内存分配的两种方式:
指针碰撞 (Bump the Pointer):这种方式适用于带有压缩功能的垃圾收集器,如Minor GC中的新生代(Young Generation)。在这种分配策略中,所有用过的内存放在一边,空闲的内存放在另一边,中间有一个指针分界。当分配一个新对象时,只需要移动这个指针即可,从而快速完成分配。但是这种方式要求内存区域必须是连续的,所以需要定期的内存压缩来整理内存碎片。
- **指针碰撞内存分配策略不适合没有压缩功能的垃圾收集器。**指针碰撞(Bump the Pointer)策略依赖内存区域的连续性,更适合在具有压缩功能的垃圾收集器中使用。分配对象时,只需将指针从已分配内存的末端向空闲内存的方向移动所需的大小即可。这种方式简单快速,但随着对象的分配和回收,会出现内存碎片。如果垃圾收集器没有压缩(Compaction)功能,随着时间的推移,内存碎片会越来越多。即使堆中还有足够的总空间,也可能找不到连续的空间来分配较大的对象。这种情况被称为“内存碎片化”。在没有压缩功能的垃圾收集器中,通常使用空闲列表(Free List)策略来管理内存。垃圾收集器维护一个所有空闲内存块的列表。需要分配新对象时,在列表中查找并重用适合大小的空闲块。这种方式处理内存分配请求的速度比指针碰撞慢,维护空闲列表需要更多的计算。但它可以更有效地应对内存碎片化问题,使得内存利用率更高。
空闲列表 (Free List):这种方式适用于老年代(Old Generation)或堆内存中未压缩的区域。在这种策略中,堆内存中所有的空闲内存块都会被维护在一个列表中。当需要分配内存时,垃圾收集器会遍历这个列表,寻找一个足够大的空闲内存块来存放新对象。这种方式的优点是可以更灵活地利用内存空间。但分配速度比指针碰撞慢,并且可能会有更多的内存碎片。
选择以上两种方式中的哪一种,取决于 Java 堆内存是否规整。而 Java 堆内存是否规整,取决于 GC 收集器的算法是"标记-清除",还是"标记-整理"(也称作"标记-压缩")。值得注意的是,复制算法内存也是规整的。具体来说:当使用带压缩整理过程的收集器(例如 Serial 和 ParNew)时,采用指针碰撞分配,既简单又高效。当使用 CMS 这种基于清除(Sweep)算法的收集器时,理论上就只能采用空闲列表来分配内存。
内存分配并发问题
在创建对象的时候有一个重要的问题,就是线程安全。在实际开发过程中,创建对象是频繁的事情。即使仅仅修改一个指针所指向的位置,并发时也并非线程安全。例如正在给对象 A 分配内存、指针还没来得及修改时,对象 B 又同时用原来的指针分配内存。作为虚拟机来说,必须要保证线程是安全的,通常来讲,虚拟机采用两种方式来保证线程安全:
CAS+失败重试:CAS 是乐观锁的一种实现方式。乐观锁的思路是:每次不加锁,假设没有冲突去完成某项操作。如果因为冲突失败就重试,直到成功为止。虚拟机采用 CAS 配上失败重试的方式保证更新操作的原子性。
TLAB:把内存分配按线程划分空间,即为每个线程预先在 Eden 区分配一块内存。JVM 在给线程中的对象分配内存时,首先在 TLAB 分配。当对象大于 TLAB 中的剩余内存,或 TLAB 的内存已用尽时,再采用上述的 CAS 方式分配内存。只有本地缓冲区用完了,分配新的缓存区时才需要同步锁定。
虚拟机是否使用 TLAB,可以通过
-XX:+/-UseTLAB参数来设定。
Step3:初始化零值
内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头)。这一步操作保证了对象的实例字段在 Java 代码中可以不赋初始值就直接使用。程序能访问到这些字段的数据类型所对应的零值。
如果使用了 TLAB,这一项工作也可以提前至 TLAB 分配时完成。
Step4:设置对象头
初始化零值完成之后,虚拟机要对对象做必要的设置。例如设置这个对象是哪个类的实例、如何才能找到类的元数据信息。还要设置对象的哈希码、对象的 GC 分代年龄。 这些信息存放在对象头中。 另外,根据虚拟机当前运行状态的不同,如是否启用偏向锁,对象头会有不同的设置方式。
Step5:执行 init 方法
在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了。但从 Java 程序的视角来看,对象创建才刚开始,<init> 方法还没有执行,所有的字段都还为零。所以一般来说,执行 new 指令之后会接着执行 <init> 方法,把对象按照程序员的意愿初始化。这样一个真正可用的对象才算完全产生出来。
通过其他方式创建的对象此时不一定执行构造方法,比如克隆对象。
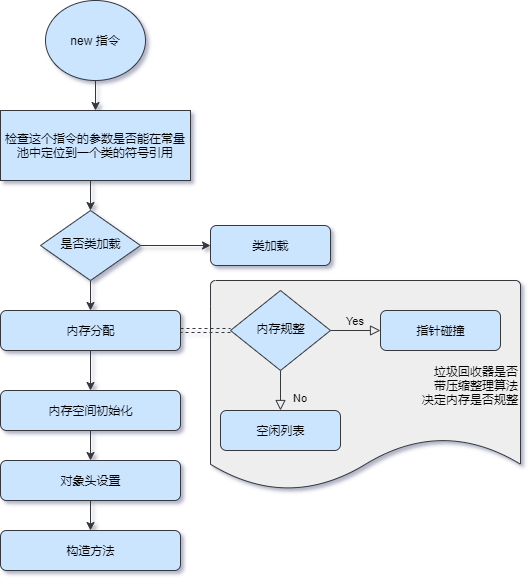
(上图为「从虚拟机的角度看对象的创建与访问」一文对上述五步流程的另一种图示)
补充阅读
- 求你了,别再说Java对象都是在堆内存上分配空间的了!:https://www.hollischuang.com/archives/4521
3.2 对象的内存布局
在 Hotspot 虚拟机中,对象在内存中的布局可以分为 3 块区域:对象头、实例数据和对齐填充。
Hotspot 虚拟机的对象头包括两部分信息。第一部分用于存储对象自身的运行时数据(例如哈希码、GC 分代年龄、锁状态标志)。另一部分是类型指针,即对象指向它的类元数据的指针。虚拟机通过这个指针来确定这个对象是哪个类的实例。
实例数据部分是对象真正存储的有效信息,也是在程序中所定义的各种类型的字段内容。
对齐填充部分不是必然存在的,也没有什么特别的含义,仅仅起占位作用。 因为 Hotspot 虚拟机的自动内存管理系统要求对象起始地址必须是 8 字节的整数倍。换句话说就是对象的大小必须是 8 字节的整数倍。而对象头部分正好是 8 字节的倍数(1 倍或 2 倍)。因此,当对象实例数据部分没有对齐时,就需要通过对齐填充来补全。
3.2.1 对象头详解(Mark Word、类型指针与实战,整理自「从虚拟机的角度看对象的创建与访问」)
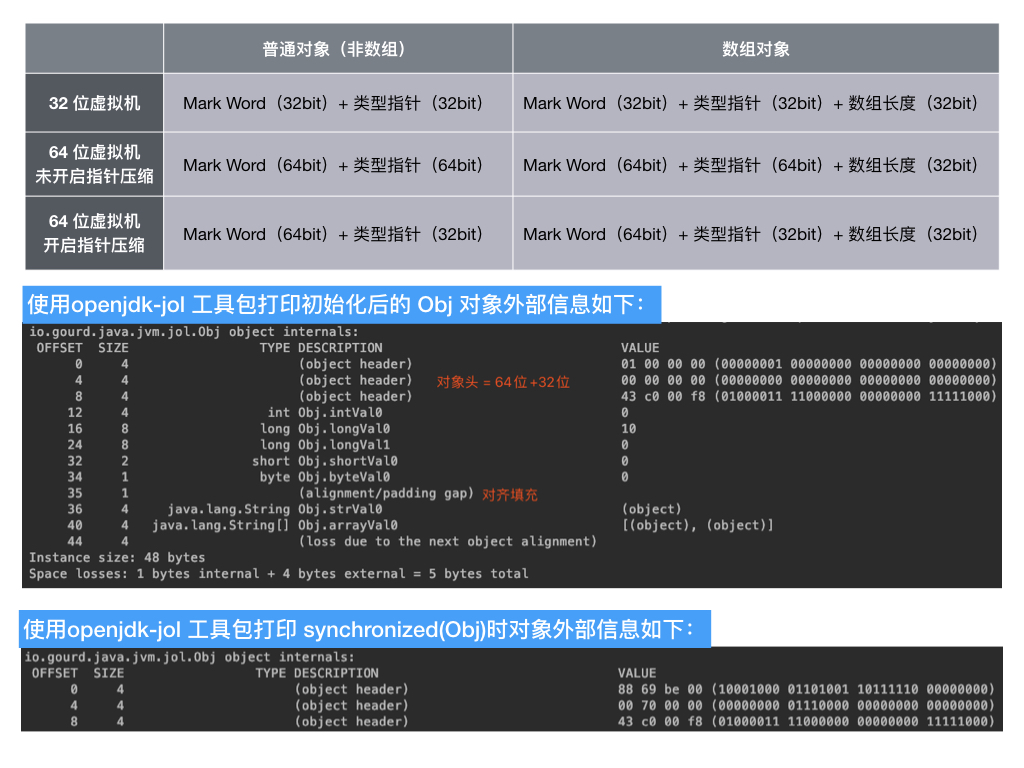
HotSpot 虚拟机对象的对象头部分包括两类信息:对象头信息(Mark Word) 与 类型指针。
对象头信息(Mark Word)
对象头信息用于存储对象自身的运行时数据,如哈希码、GC 分代年龄、锁状态标志。还包括线程持有的锁、偏向线程 ID、偏向时间戳。
这部分数据的长度在 32 位和 64 位的虚拟机(未启用压缩指针)中分别为 32 bit和 64 bit。
对象头信息设计成一个有着动态定义的数据结构,以便在极小的空间内存储尽量多的数据。对象头信息根据对象的状态复用自己的存储空间。
比如锁的升级过程,头信息会一直变换,不同的标识位代表不同的锁类型
下面为 64 位虚拟机对象头标志位:
java
|------------------------------------------------------------------------|
|                            Mark Word (64 bits)                         |
|------------------------------------------------------------------------|
| unused:25   | hashcode:31 | unused:1 | GC年龄:4 | 是否是偏向锁:1 | lock:2    无锁
|------------------------------------------------------------------------|
| threadId:54 | 偏向时间戳:2  | unused:1 | GC年龄:4 | 是否是偏向锁:1 | lock:2    偏向锁
|------------------------------------------------------------------------|
|              指向栈中锁记录的指针:62                              | lock:2    轻量级锁
|------------------------------------------------------------------------|
|              指向管程 Monitor 的指针:62                          | lock:2    重量级锁
|------------------------------------------------------------------------|
|                                                               | lock:2     GC 标识
|------------------------------------------------------------------------|
类型指针(对象头信息-类型指针)
对象头类型指针对象是指向它的类型元数据的指针
Java 虚拟机通过这个指针来确定该对象是哪个类的实例
并不是所有虚拟机实现都必须在对象上保留类型指针。查找对象的元数据信息并不一定要经过对象本身。
此外,如果对象是一个 Java 数组,那在对象头中还必须有一块用于记录数组长度的数据。因为虚拟机可以通过普通 Java 对象的元数据信息确定 Java 对象的大小。但是如果数组的长度是不确定的,将无法通过元数据中的信息推断出数组的大小。
对象头信息实战
我们使用 openjdk 的一个工具包 Code Tools-jol 打印对象信息。 源代码,部分伪代码如下:
java
class Obj {
    long longVal0 = 10;
    int intVal0;
    long longVal1;
    byte byteVal0;
    short shortVal0;
    String strVal0 = "hello world";
    String[] arrayVal0 = new String[]{strVal0, strVal0};
}

final Obj obj = new Obj();
final ClassLayout classLayout = ClassLayout.parseInstance(obj);

// 初始化后打印
out.println(classLayout.toPrintable());

synchronized (obj) {
    // 加锁后后打印
    out.println(classLayout.toPrintable());
}
启用指针压缩,最终执行效果如下:
3.2.2 实例数据的存储顺序
无论是从父类继承下来的,还是在子类中定义的字段都必须记录起来。
HotSpot 虚拟机默认的分配顺序为 longs/doubles、ints、shorts/chars、bytes/booleans、oops(普通对象指针)。 从默认的分配策略中可以看到,相同宽度的字段总是被分配到一起存放。在满足这个前提条件的情况下,在父类中定义的变量会出现在子类之前。
这部分的存储顺序会受到虚拟机分配策略参数(
-XX:FieldsAllocationStyle参数)和字段在 Java 源码中定义顺序的影响。 如果 HotSpot 虚拟机的+XX:CompactFields参数值为 true(默认为 true),那较窄的子类变量也允许插入父类变量的空隙中。这样可以节省出一点点空间。
3.3 对象的访问定位
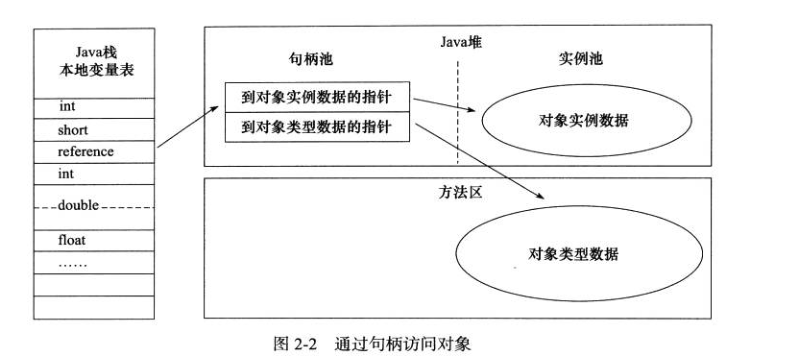
建立对象就是为了使用对象,我们的 Java 程序通过栈上的 reference 数据来操作堆上的具体对象。对象的访问方式由虚拟机实现而定,目前主流的访问方式有①使用句柄和②直接指针两种:
- 句柄: 如果使用句柄,那么 Java 堆中将会划分出一块内存来作为句柄池。reference 中存储的就是对象的句柄地址。句柄中包含了对象实例数据与类型数据各自的具体地址信息;
- 直接指针: 使用直接指针访问时,必须考虑访问类型数据相关信息的放置。这些信息放在 Java 堆对象的布局中。reference 中存储的直接就是对象的地址。
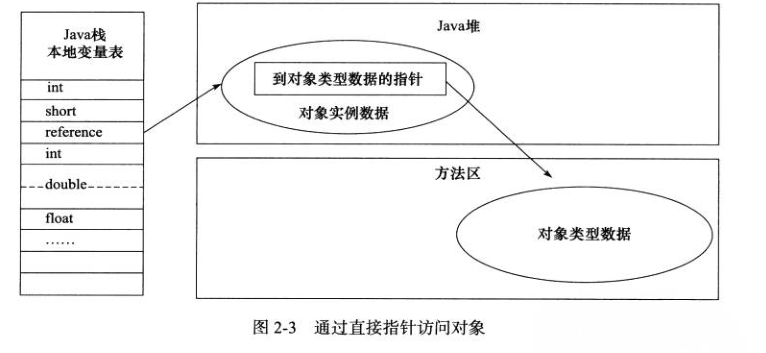
这两种对象访问方式各有优势。使用句柄来访问的最大好处是 reference 中存储的是稳定的句柄地址。在对象被移动时,只会改变句柄中的实例数据指针,reference 本身不需要修改。使用直接指针访问方式最大的好处就是速度快,它节省了一次指针定位的时间开销。由于对象访问在 Java 中频繁,这类开销积少成多也是一项极为可观的执行成本。
HotSpot 虚拟机主要使用第二种方式(直接指针)。例外:使用 Shenandoah 收集器时会有一次额外的转发,具体可参见收集器章节。(整理自「从虚拟机的角度看对象的创建与访问」)
3.4 如何判断对象是否是否存活
来自:https://blog.csdn.net/TimHeath/article/details/53055193
堆中几乎存放着Java世界中所有的对象实例。垃圾收集器在对堆回收之前,第一件事情就是要确定这些对象哪些还“存活”着,哪些对象已经“死去”。“死去”即不可能再被任何途径使用的对象。下面说明确认这些对象存活与否的办法。
在主流的商用程序语言中(例如Java和C#),都是使用可达性分析算法(Reachability Analysis)来判断对象是否存活的。但是又有很多人认为是用引用计数算法(Reference Counting)来判断。接下来我会分别介绍这两种算法。
引用计数算法
很多教科书判断对象是否存活的算法是这样的:给对象中添加一个引用计数器。每当有一个地方引用它时,计数器值加1;当引用失效时,计数器减1。任何时刻计数器都为0的对象就是不可能再被使用的。
引用计数算法(Reference Counting)的实现简单,判断效率也高,在大部分情况下它都是一个不错的算法。但是Java语言中没有选用引用计数算法来管理内存。其中最主要的一个原因是它很难解决对象之间相互循环引用的问题。
例如下面这段代码,对象objA和objB都有字段instance,赋值令objA.instance=objB及objB.instance=objA。除此之外这两个对象再无任何引用。这两个对象都已经不能再被访问,但是它们因为相互引用着对方,所以它们的引用计数都不为0。如果使用引用计数算法,GC收集器就不会回收它们。
java
public class ReferenceCountingGC {

    private ReferenceCountingGC instance = null;
    private static final int _1m = 1024*1024;
    //只是为了占点内存
    private byte[] bigSize = new byte[2*_1m];

    public static void main(String[] args) {
        ReferenceCountingGC objA = new ReferenceCountingGC();
        ReferenceCountingGC objB = new ReferenceCountingGC();

        objA.instance = objB;
        objB.instance = objA;

        objA = null;
        objB = null;

        System.gc();
    }
}
输出结果
java
[GC (System.gc()) [PSYoungGen: 6758K->632K(38400K)] 6758K->640K(125952K), 0.0008264 secs] [Times: user=0.00 sys=0.00, real=0.00 secs]
[Full GC (System.gc()) [PSYoungGen: 632K->0K(38400K)] [ParOldGen: 8K->537K(87552K)] 640K->537K(125952K), [Metaspace: 2755K->2755K(1056768K)], 0.0053125 secs] [Times: user=0.00 sys=0.00, real=0.01 secs]
Heap
 PSYoungGen      total 38400K, used 333K [0x00000000d5c00000, 0x00000000d8680000, 0x0000000100000000)
  eden space 33280K, 1% used [0x00000000d5c00000,0x00000000d5c534a8,0x00000000d7c80000)
  from space 5120K, 0% used [0x00000000d7c80000,0x00000000d7c80000,0x00000000d8180000)
  to   space 5120K, 0% used [0x00000000d8180000,0x00000000d8180000,0x00000000d8680000)
 ParOldGen       total 87552K, used 537K [0x0000000081400000, 0x0000000086980000, 0x00000000d5c00000)
  object space 87552K, 0% used [0x0000000081400000,0x00000000814864e0,0x0000000086980000)
 Metaspace       used 2762K, capacity 4486K, committed 4864K, reserved 1056768K
  class space    used 299K, capacity 386K, committed 512K, reserved 1048576K
PSYoungGen: 6758K->632K(38400K),新生代内存从6758K到清理后的632K。很明显GC收集器回收了objA和objB。所以HotSpot虚拟机并不是采用引用计数算法来判断一个对象存活与否。
可达性分析算法
这个算法的基本思路就是通过一系列的称为“GC Roots”的对象作为起始点,从这些节点开始向下搜索。搜索所走过的路径称为引用链(Reference Chain)。当一个对象到GC Roots没有任何引用链相连时,则证明此对象是不可用的。用图论来说,就是从GC Roots到这个对象不可达。如下图所示,对象object 5、object 6、object 7虽然互相有关联,但是它们到GC Roots是不可达的。所以它们将会被判定为是可回收的对象。
在Java语言中,可作为GC Roots的对象包括下面几种:
虚拟机栈(栈帧中的本地变量表)中引用的对象。
方法区中类静态属性引用的对象。
方法区中常量引用的对象。
本地方法栈中JNI(即一般说的Native方法)引用的对象。
重点补充内容
String 类和常量池
String 对象的两种创建方式:
java
String str1 = "abcd";//先检查字符串常量池中有没有"abcd",如果字符串常量池中没有,则创建一个,然后 str1 指向字符串常量池中的对象,如果有,则直接将 str1 指向"abcd"";
String str2 = new String("abcd");//堆中创建一个新的对象
String str3 = new String("abcd");//堆中创建一个新的对象
System.out.println(str1==str2);//false
System.out.println(str2==str3);//false
这两种不同的创建方法是有差别的。
- 第一种方式是在常量池中拿对象;
- 第二种方式是直接在堆内存空间创建一个新的对象。
记住一点:只要使用 new 方法,便需要创建新的对象。
再给大家一个图应该更容易理解,图片来源:https://www.journaldev.com/797/what-is-java-string-pool
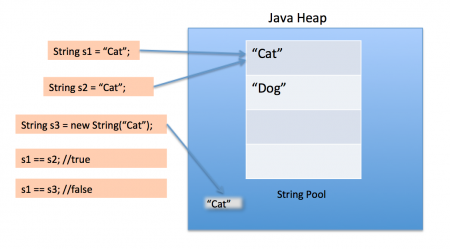
String 类型的常量池比较特殊。它的主要使用方法有两种:
- 直接使用双引号声明出来的 String 对象会直接存储在常量池中。
- 如果不是用双引号声明的 String 对象,可以使用 String 提供的 intern 方法。String.intern() 是一个 Native 方法。它的作用如下。如果运行时常量池中已经包含一个等于此 String 对象内容的字符串,返回常量池中该字符串的引用。如果没有,JDK1.7之前(不包含1.7)在常量池中创建与此 String 内容相同的字符串,并返回该字符串的引用。JDK1.7以及之后在常量池中记录此字符串的引用,并返回该引用。
java
String s1 = new String("计算机");
String s2 = s1.intern();
String s3 = "计算机";
System.out.println(s2);//计算机
System.out.println(s1 == s2);//false,因为一个是堆内存中的 String 对象一个是常量池中的 String 对象,
System.out.println(s3 == s2);//true,因为两个都是常量池中的 String 对象字符串拼接:
java
String str1 = "str";
String str2 = "ing";

String str3 = "str" + "ing";//常量池中的对象
String str4 = str1 + str2; //在堆上创建的新的对象
String str5 = "string";//常量池中的对象
System.out.println(str3 == str4);//false
System.out.println(str3 == str5);//true
System.out.println(str4 == str5);//false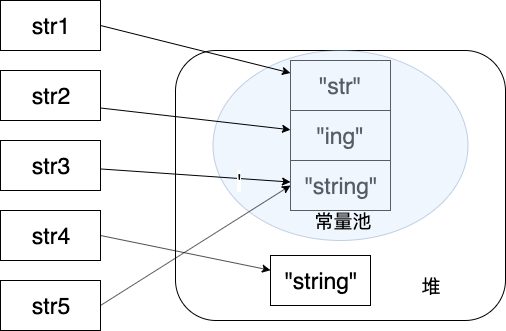
尽量避免多个字符串拼接,因为这样会重新创建对象。如果需要改变字符串,可以使用 StringBuilder 或者 StringBuffer。
String s1 = new String("abc");这句话创建了几个字符串对象?
将创建 1 或 2 个字符串。如果池中已存在字符串常量“abc”,则只会在堆空间创建一个字符串常量“abc”。如果池中没有字符串常量“abc”,那么它将首先在池中创建,然后在堆空间中创建。因此将创建总共 2 个字符串对象。
验证:
java
String s1 = new String("abc");// 堆内存的地址值
String s2 = "abc";
System.out.println(s1 == s2);// 输出 false,因为一个是堆内存,一个是常量池的内存,故两者是不同的。
System.out.println(s1.equals(s2));// 输出 true
结果:
java
false
true
8 种基本类型的包装类和常量池
Java 基本类型的包装类的大部分都实现了常量池技术,即 Byte,Short,Integer,Long,Character,Boolean。前面 4 种包装类默认创建了数值[-128,127] 的相应类型的缓存数据。Character创建了数值在[0,127]范围的缓存数据。Boolean 直接返回True Or False。如果超出对应范围仍然会去创建新的对象。为啥把缓存设置为[-128,127]区间?(参见issue/461)性能和资源之间的权衡。
java
public static Boolean valueOf(boolean b) {
    return (b ? TRUE : FALSE);
}
java
private static class CharacterCache {
    private CharacterCache(){}

    static final Character cache[] = new Character[127 + 1];
    static {
        for (int i = 0; i < cache.length; i++)
            cache[i] = new Character((char)i);
    }
}
两种浮点数类型的包装类 Float,Double 并没有实现常量池技术。
java
Integer i1 = 33;
Integer i2 = 33;
System.out.println(i1 == i2);// 输出 true
Integer i11 = 333;
Integer i22 = 333;
System.out.println(i11 == i22);// 输出 false
Double i3 = 1.2;
Double i4 = 1.2;
System.out.println(i3 == i4);// 输出 false
Integer 缓存源代码:
java
/**
* 此方法将始终缓存-128 到 127(包括端点)范围内的值,并可以缓存此范围之外的其他值。
*/
public static Integer valueOf(int i) {
if (i >= IntegerCache.low && i <= IntegerCache.high)
return IntegerCache.cache[i + (-IntegerCache.low)];
return new Integer(i);
}应用场景:
- Integer i1=40;Java 在编译的时候会直接将代码封装成 Integer i1=Integer.valueOf(40);。这样就会使用常量池中的对象。
- Integer i1 = new Integer(40);这种情况下会创建新的对象。
java
Integer i1 = 40;
Integer i2 = new Integer(40);
System.out.println(i1==i2);//输出 false
Integer 比较更丰富的一个例子:
java
Integer i1 = 40;
Integer i2 = 40;
Integer i3 = 0;
Integer i4 = new Integer(40);
Integer i5 = new Integer(40);
Integer i6 = new Integer(0);

System.out.println("i1=i2   " + (i1 == i2));
System.out.println("i1=i2+i3   " + (i1 == i2 + i3));
System.out.println("i1=i4   " + (i1 == i4));
System.out.println("i4=i5   " + (i4 == i5));
System.out.println("i4=i5+i6   " + (i4 == i5 + i6));
System.out.println("40=i5+i6   " + (40 == i5 + i6));
结果:
java
i1=i2   true
i1=i2+i3   true
i1=i4   false
i4=i5   false
i4=i5+i6   true
40=i5+i6   true
解释:
语句 i4 == i5 + i6,因为+这个操作符不适用于 Integer 对象,首先 i5 和 i6 自动拆箱,做数值相加,即 i4 == 40。然后 Integer 对象无法与数值直接比较,所以 i4 自动拆箱转为 int 值 40。最终这条语句转为 40 == 40 做数值比较。
附:对象的内存布局图解(32 位与 64 位)
来源:对象的内存布局 https://www.cnblogs.com/duanxz/p/4967042.html
2026-10 整改:本附删去与 3.2 节重复的文字说明。仅保留布局图、字节占用清单与 Mark Word 32 位拆解。
32位
64位
从上面的这张图里面可以看出,对象在内存中的结构主要包含以下几个部分:
对象头:
Mark Word(标记字段):关于锁的信息。占 4 或 8 个字节,表示锁状态(如偏向锁标记位、轻量级锁标记位)。另外还用于 GC 分代年龄、存放对象 hashCode。
Klass Pointer(Class对象指针):大小也是4个字节/8个字节。其指向的位置是对象对应的Class对象(其对应的元数据对象)的内存地址。
数组长度:如果对象是数组类型,占用4个字节/8个字节。JVM 无法从数组的元数据确认数组大小,所以要用一块来记录数组长度。
Instance Data(对象实际数据):包括对象的所有成员变量。byte和boolean是1个字节,short和char是2个字节,int和float是4个字节。long和double是8个字节,reference是4个字节。1字节 = 8bit。
padding data(对齐):数据所占空间不能被8整除时,padding占用空间凑齐至8的倍数,读取数据更快。
32 位无锁状态下,Mark Word 存 25 bit 哈希码、4 bit 分代年龄、2 bit 锁标志位、1 bit 固定 0。其他状态(轻量级/重量级锁定、GC 标记、可偏向)下的存储内容见下表。