Appearance
HashMap底层数据结构
看在前面
- 感谢美团技术团队分享-->Java 8系列之重新认识HashMap
- [感谢Snailclimb-->JavaGuide-->HashMap]((原链已失效 2026-10,内容已在本篇/本库))
- HashMap 进阶篇那些唬人的名词: Resize, Capacity, bucket,Load factor
Map接口UML图
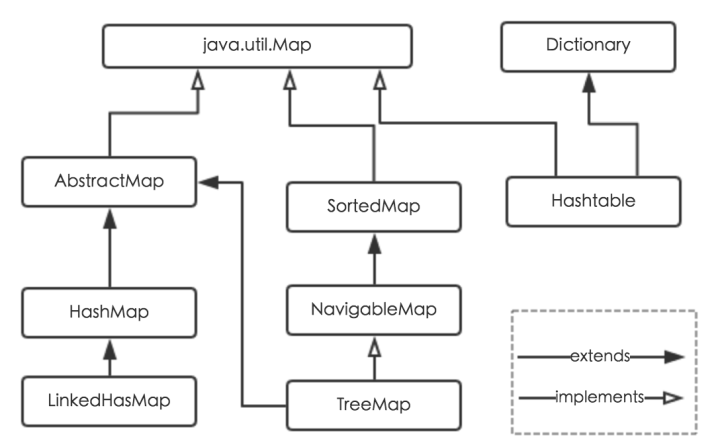
HashMap 简介
HashMap 主要用来存放键值对,它基于哈希表的Map接口实现,是常用的Java集合之一。
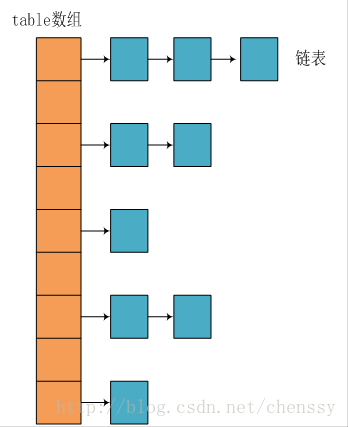
JDK1.8之前HashMap由 数组+链表 组成,数组是HashMap的主体。链表则是主要为了解决哈希冲突而存在的(“拉链法”解决冲突)。
JDK1.8以后在解决哈希冲突时有了较大的变化。当链表长度大于阈值(默认为8)时,将链表转化为红黑树,以减少搜索时间。将链表转换成红黑树前会判断。如果当前数组的长度小于64,那么会先对数组扩容,而不是转换为红黑树。具体实现可以参照 treeifyBin 方法。
HashMap 底层数据结构
JDK1.8之前
JDK1.8 之前 HashMap 底层是 数组和链表 结合在一起使用也就是 链表散列。HashMap 通过key的hashCode经过 扰动函数 处理过后得到hash值。然后通过 (n - 1) & hash 判断当前元素存放的位置(这里的n指的是数组的长度)。如果当前位置存在元素,就判断该元素与要存入的元素的hash值以及key是否相同。如果相同,直接覆盖。不相同就通过拉链法解决冲突。
所谓扰动函数指的就是 HashMap 的 hash 方法。使用 hash 方法也就是扰动函数,是为了防止一些实现差的 hashCode() 方法。换句话说使用扰动函数之后可以减少碰撞。
JDK 1.8 HashMap 的 hash 方法源码:
JDK 1.8 的 hash方法 相比于 JDK 1.7 hash 方法更加简化,但是原理不变。
java
static final int hash(Object key) {
    int h;
    // key.hashCode():返回散列值也就是hashcode
    // ^ :按位异或
    // >>>:无符号右移,忽略符号位,空位都以0补齐
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
其中JDK1.8的hash实现,可以这么理解:
在Java 1.8的实现中,是通过hashCode()的高16位异或低16位实现的 (h = k.hashCode()) ^ (h >>> 16) ,主要是从速度、功效、质量来考虑的。这么做可以在bucket的n小的时候,也能保证考虑到高低bit 都参与到hash的计算中。同时不会有太大的开销。
对比 JDK1.7的 HashMap 的 hash 方法源码.
java
static int hash(int h) {
    // This function ensures that hashCodes that differ only by
    // constant multiples at each bit position have a bounded
    // number of collisions (approximately 8 at default load factor).

    h ^= (h >>> 20) ^ (h >>> 12);
    return h ^ (h >>> 7) ^ (h >>> 4);
}
相比于 JDK1.8 的 hash 方法 ,JDK 1.7 的 hash 方法的性能会稍差一点点,因为毕竟扰动了 4 次。
所谓 “拉链法” 就是:将链表和数组相结合。即创建一个链表数组,数组中每一格就是一个链表。若遇到哈希冲突,则将冲突的值加到链表中即可。
JDK1.8之后
相比于之前的版本,jdk1.8在解决哈希冲突时有了较大的变化。当链表长度大于阈值(默认为8)时,将链表转化为红黑树,以减少搜索时间。
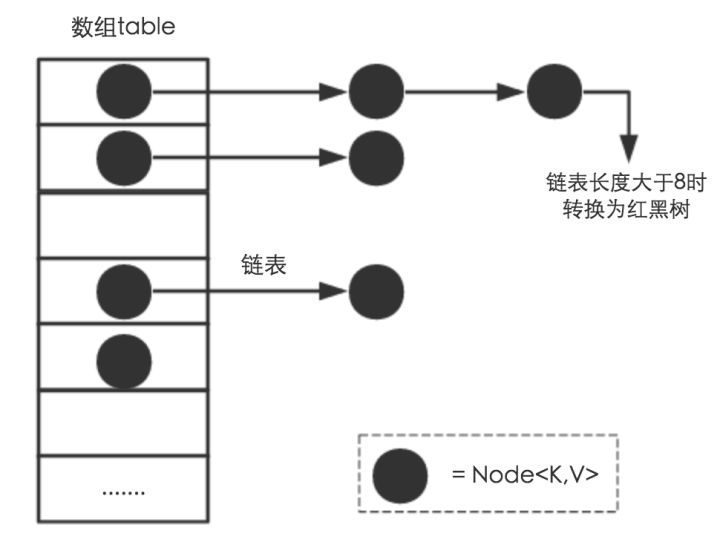
TreeMap、TreeSet以及JDK1.8之后的HashMap底层都用到了红黑树。红黑树就是为了解决二叉查找树的缺陷,因为二叉查找树在某些情况下会退化成一个线性结构。
来源:敖丙系列(原文字链已失效 2026-10 核实)——本文为早期整理篇,内容经本库体例改写。