Appearance
MySQL索引详解
看在前面
- 数据库两大神器【索引和锁】
- [JavaGuide:MySQL Index]((原链已失效 2026-10,内容已在本篇/本库))(下方思维导图及部分补充内容的来源)
掘金特邀作者 | 技术公众号:Java3 y
**文章导航:(原链已失效 2026-10,内容已在本篇/本库)
声明:如果没有说明具体的数据库和存储引擎,默认指的是MySQL中的InnoDB存储引擎
思维导图-索引篇
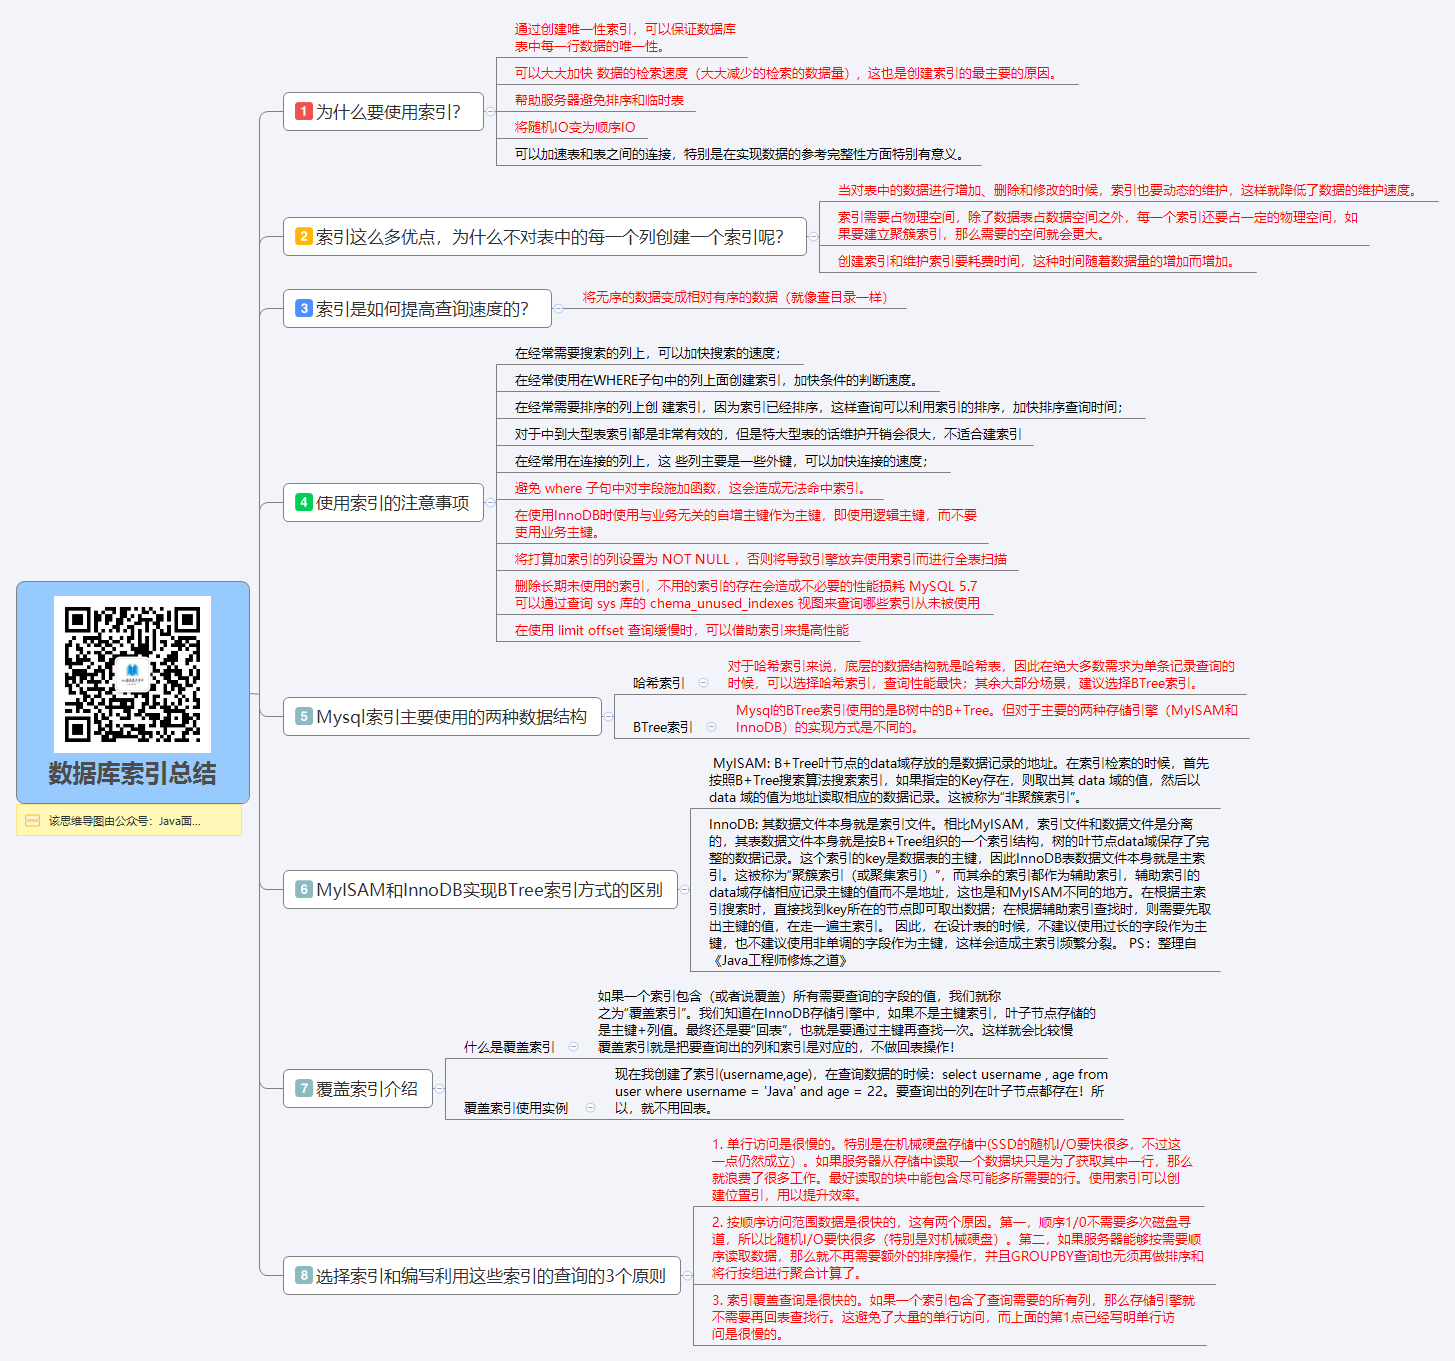
一、索引
在之前,我对索引有以下的认知:
- 索引可以加快数据库的检索速度
- 表经常做
INSERT/UPDATE/DELETE操作就不要建立索引了。换言之:索引会降低插入、删除、修改这类维护任务的速度。 - 索引需要占物理和数据空间。
- 了解过索引的最左匹配原则
- 知道索引的分类:聚集索引和非聚集索引
- Mysql支持Hash索引和B+树索引两种
看起来好像啥都知道,但面试让你说的时候可能就GG了:
- 使用索引为什么可以加快数据库的检索速度啊?
- 为什么说索引会降低插入、删除、修改这类维护任务的速度。
- 索引的最左匹配原则指的是什么?
- Hash索引和B+树索引有什么区别?主流的使用哪一个居多?InnoDB存储都支持吗?
- 聚集索引和非聚集索引有什么区别?
- ......
1.1聊聊索引的基础知识
首先Mysql的基本存储结构是页(记录都存在页里边):
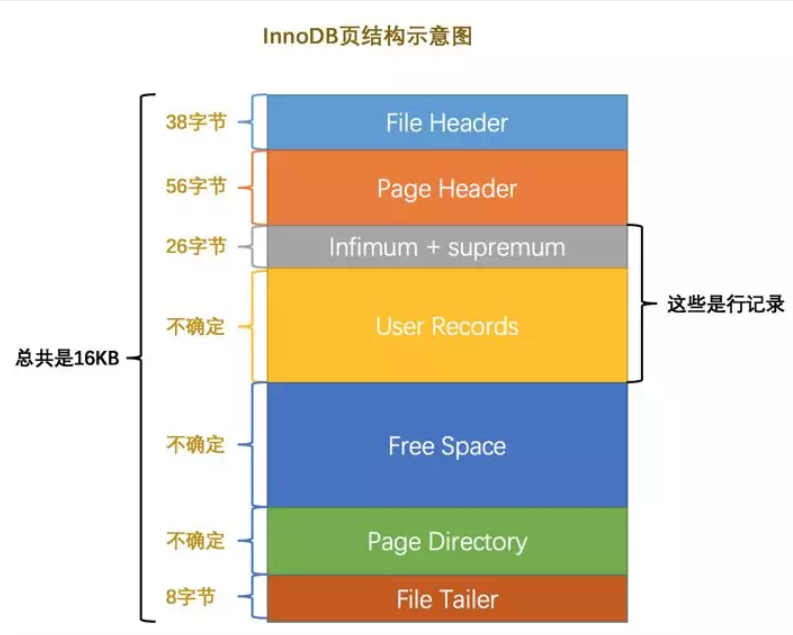
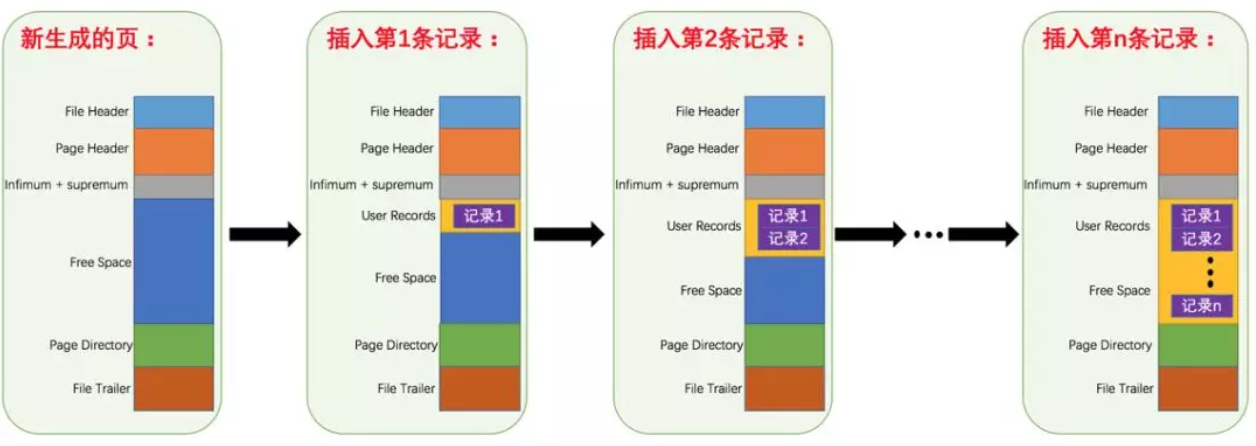
各个数据页可以组成一个双向链表
每个数据页中的记录又可以组成一个单向链表
每个数据页都会为存储在它里边儿的记录生成一个页目录。通过主键查找某条记录时,可以在页目录中使用二分法快速定位到对应的槽。然后再遍历该槽对应分组中的记录,即可快速找到指定的记录
以其他列(非主键)作为搜索条件:只能从最小记录开始一次遍历单链表中的每条记录。
所以说,如果我们写
sql
select * from user where indexname = 'xxx'这样没有做任何优化的sql语句,默认会这样做:
- 定位到记录所在的页:需要遍历双向链表,找到所在的页
- 从所在的页内查找相应的记录。由于不是根据主键查询,只能遍历所在页的单链表
很明显,在数据量很大的情况下这样查询会很慢。这样的时间复杂度为O(N);
1.2索引提高检索速度
索引加快查询速度的原理:
就是将无序的数据变成有序(相对):
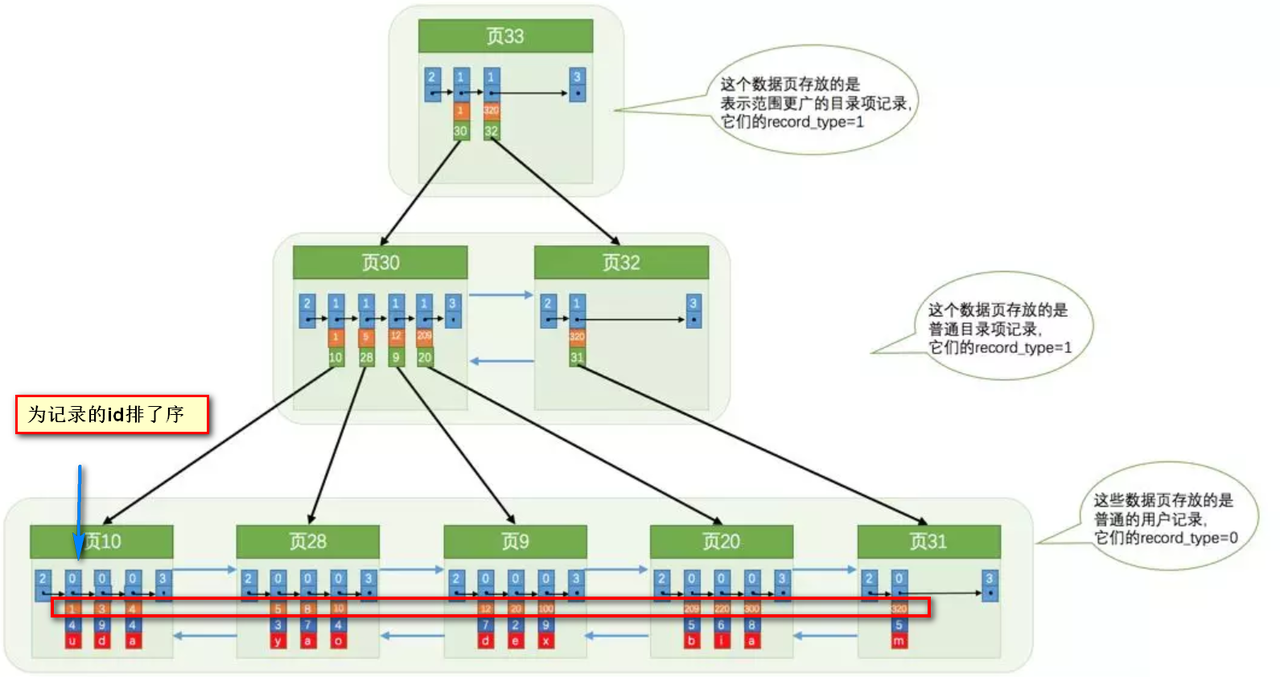
要找到id为8的记录简要步骤:
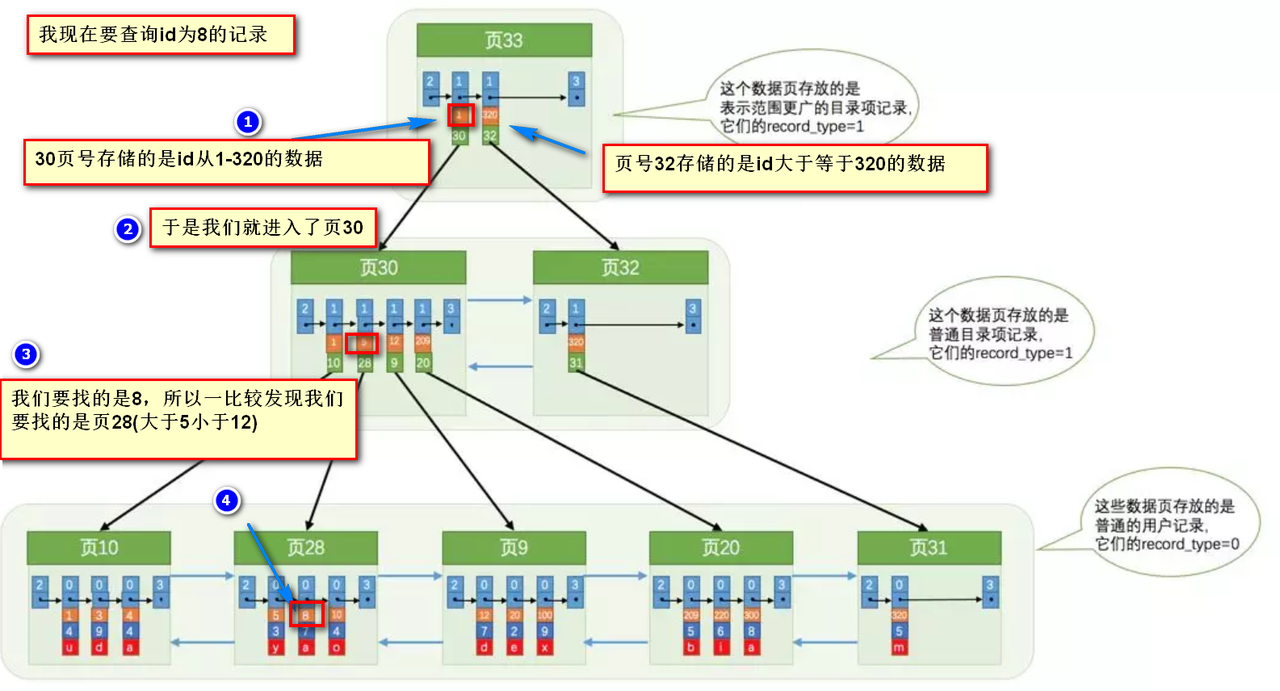
很明显的是:没有用索引我们是需要遍历双向链表来定位对应的页。现在通过“目录”就可以很快地定位到对应的页上(二分查找,时间复杂度近似为O(logn))。
底层结构就是B+树。B+树作为树的一种实现,能够让我们很快地查找出对应的记录。
参考资料:
1.3索引降低增删改的速度
B+树是平衡树的一种。
平衡树:它是一棵空树,或它的左右两个子树的高度差的绝对值不超过1。并且左右两个子树都是一棵平衡二叉树。
如果一棵普通的树在极端的情况下,是能退化成链表的(树的优点就不复存在了)
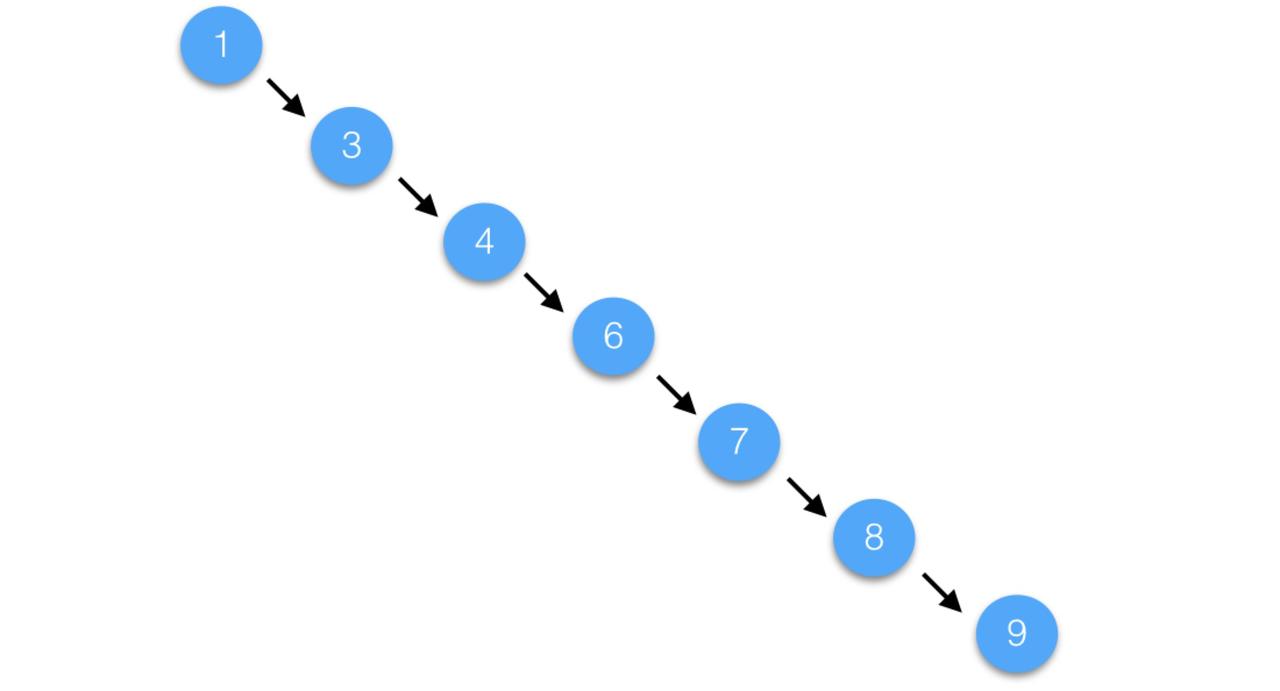
B+树是平衡树的一种,是不会退化成链表的,树的高度都不高(本符合矮矮胖胖(均衡)的结构)。【这样一来我们检索的时间复杂度就是O(logn)】。从上一节的图我们也可以看见,建立索引就是建立一颗B+树。
- B+树是一颗平衡树,如果我们对这颗树增删改,那肯定会破坏它的原有结构。
- 要维持平衡树,就必须做额外的工作。正因为这些额外的工作开销,导致索引会降低增删改的速度
B+树删除和修改具体可参考:
1.4哈希索引
除了B+树之外,还有一种常见的是哈希索引。
哈希索引就是采用一定的哈希算法,把键值换算成新的哈希值。检索时不需要类似B+树那样从根节点到叶子节点逐级查找。只需一次哈希算法即可立刻定位到相应的位置,速度快。
- 本质上就是把键值换算成新的哈希值,根据这个哈希值来定位。
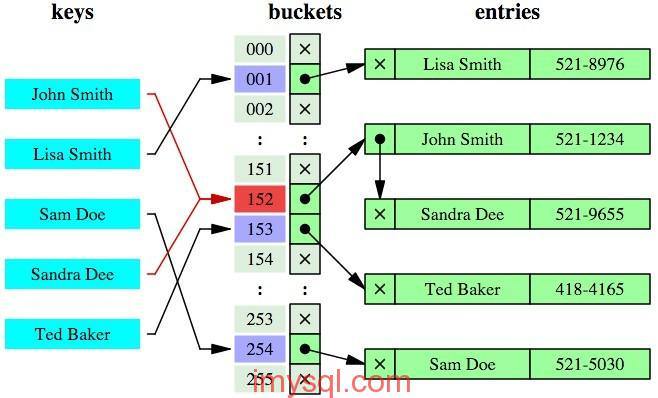
看起来哈希索引很牛逼啊,但哈希索引有好几个局限(根据他本质的原理可得):
- 哈希索引也没办法利用索引完成排序
- 不支持最左匹配原则
- 在重复键值多时,哈希索引的效率也是极低的---->哈希碰撞问题
- 不支持范围查询
参考资料:
1.5InnoDB支持哈希索引吗?
主流的还是使用B+树索引。对于哈希索引,InnoDB是自适应哈希索引的(hash索引的创建由InnoDB存储引擎自动优化创建,我们干预不了)。
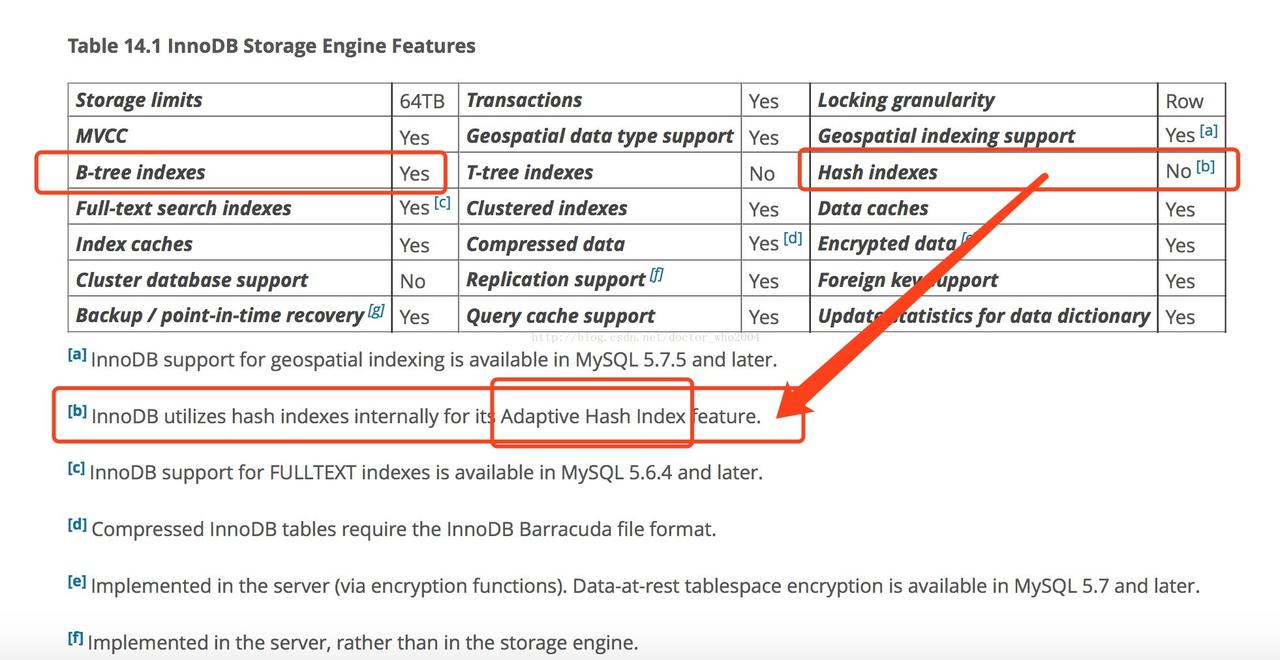
参考资料:
1.6聚集和非聚集索引
简单概括:
- 聚集索引就是以主键创建的索引
- 非聚集索引就是以非主键创建的索引
区别:
- 聚集索引在叶子节点存储的是表中的数据
- 非聚集索引在叶子节点存储的是主键和索引列
- 使用非聚集索引查询出数据时,拿到叶子上的主键再去查到想要查找的数据。(拿到主键再查找这个过程叫做回表)
非聚集索引也叫做二级索引,不用纠结那么多名词,将其等价就行了~
非聚集索引在建立的时候也未必是单列的,可以多个列来创建索引。
此时就涉及到了哪个列会走索引,哪个列不走索引的问题了(最左匹配原则-->后面有说)
创建多个单列(非聚集)索引的时候,会生成多个索引树(所以过多创建索引会占用磁盘空间)
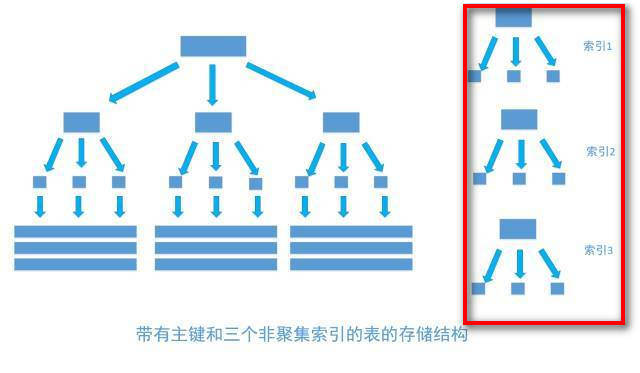
在创建多列索引中也涉及到了一种特殊的索引-->覆盖索引
- 我们前面知道了,如果不是聚集索引,叶子节点存储的是主键+列值
- 最终还是要“回表”,也就是要通过主键再查找一次。这样就会变慢
- 覆盖索引就是把要查询出的列和索引是对应的,不做回表操作。
比如说:
- 现在我创建了索引
(username,age),在查询数据的时候:select username , age from user where username = 'Java3y' and age = 20。 - 我们上边的查询是走索引的,并且要查询出的列在叶子节点都存在。所以,就不用回表了~
- 所以,能使用覆盖索引就尽量使用吧~
1.7索引最左匹配原则
最左匹配原则:
- 索引可以简单如一个列
(a),也可以复杂如多个列(a, b, c, d),即联合索引。 - 如果是联合索引,那么key也由多个列组成。同时,索引只能用于查找key是否存在(相等)。遇到范围查询
(>、<、between、like左匹配)等就不能进一步匹配了,后续退化为线性查找。 - 因此,列的排列顺序决定了可命中索引的列数。
例子:
- 如有索引
(a, b, c, d),查询条件a = 1 and b = 2 and c > 3 and d = 4,则会在每个节点依次命中a、b、c,无法命中d。(很简单:索引命中只能是相等匹配,不能是范围匹配)
再配合个例子:MySQL索引,最左前缀匹配的内部原理是什么?
我知道最左前缀匹配这回事,但是不知道为什么,比如:
- 建了一个索引:(a, b, c)
- 执行下面两个SQL。
java
SELECT * FROM table WHERE a = 1 AND c = 3; // c不走索引
SELECT * FROM table WHERE a = 1 AND b < 2 AND c = 3; // c不走索引
问题:我知道由于最左前缀匹配,c不走索引,但是不知道为什么,请问内部原理是什么?
因为根据a->b->c排序的时候,a相同的值都放在一起,c相同的值都不在一起,所以没办法走索引。
a-b-c这样的索引当然(在逻辑上等同于)是先找a,然后在范围里面找b,再找c。上述问题里的c会分散在很多个b里面,当然没办法走索引。
1.8=、in自动优化顺序
不需要考虑=、in的顺序,mysql会自动优化这些条件的顺序,以匹配尽可能多的索引列。
例子:
- 如有索引
(a, b, c, d),查询条件c > 3 and b = 2 and a = 1 and d < 4与a = 1 and c > 3 and b = 2 and d < 4等顺序都是可以的。MySQL会自动优化为a = 1 and b = 2 and c > 3 and d < 4,依次命中a、b、c。
1.9索引总结
索引在数据库中是一个重要的知识点。上面谈的就是索引最基本的东西,要创建出好的索引要顾及到很多的方面:
- 1、最左前缀匹配原则。这是非常重要、非常重要、非常重要(重要的事情说三遍)的原则。MySQL会一直向右匹配,直到遇到范围查询
(>,<,BETWEEN,LIKE)就停止匹配。 - 2、尽量选择区分度高的列作为索引,区分度的公式是
COUNT(DISTINCT col) / COUNT(*)。表示字段不重复的比率,比率越大我们扫描的记录数就越少。 - 3、索引列不能参与计算,尽量保持列“干净”。比如,
FROM_UNIXTIME(create_time) = '2016-06-06'就不能使用索引。原因很简单,B+树中存储的都是数据表中的字段值。但是检索时,需要把所有元素都应用函数才能比较,这样的代价太大。所以语句要写成 :create_time = UNIX_TIMESTAMP('2016-06-06')。 - 4、尽可能的扩展索引,不要新建索引。比如表中已经有了a的索引,现在要加(a,b)的索引,那么只需要修改原来的索引即可。
- 5、单个多列组合索引和多个单列索引的检索查询效果不同。因为在执行SQL时,MySQL只能使用一个索引,会从多个单列索引中选择一个限制最为严格的索引。两者之间并无关联。
参考资料:
1.10唯一索引 vs 普通索引(change buffer)
- 查询:两者差别不大。唯一索引由于定义了唯一性,找到一条满足条件的记录即停止。普通索引会顺着继续多读几条,直到不满足条件为止。多读几条的开销微乎其微;
- 更新:普通索引可以借助 change buffer 把更新动作先缓存起来,减少随机读盘。唯一索引必须先把数据页读进内存校验唯一性,用不上 change buffer,写入开销更高;
- 因此在业务上没有唯一性约束需求的列,优先选择普通索引。
1.11补充:创建索引的语法与冗余索引
以下内容整理自:《Java工程师修炼之道》
MySQL如何为表字段添加索引?
- 添加PRIMARY KEY(主键索引)
sql
ALTER TABLE `table_name` ADD PRIMARY KEY (`column`)- 添加UNIQUE(唯一索引)
sql
ALTER TABLE `table_name` ADD UNIQUE (`column`)- 添加INDEX(普通索引)
sql
ALTER TABLE `table_name` ADD INDEX index_name (`column`)- 添加FULLTEXT(全文索引)
sql
ALTER TABLE `table_name` ADD FULLTEXT (`column`)- 添加多列索引
sql
ALTER TABLE `table_name` ADD INDEX index_name (`column1`, `column2`, `column3`)注意避免冗余索引
冗余索引指的是索引的功能相同。如(name,city)和(name)这两个索引,能够命中(name)的查询肯定也能命中(name,city),(name)就是冗余索引。在大多数情况下,都应该尽量扩展已有的索引而不是创建新索引。
MySQL 5.7 版本后,可以通过查询 sys 库的 schema_redundant_indexes 表来查看冗余索引。
补充:ORDER BY 子句同样遵循最左前缀规则。创建联合索引时,字段顺序要看去重后个数的多少,个数多的放前面。
参考
- 《Java工程师修炼之道》
- 《MySQL高性能书籍_第3版》